

Üç para atışının bütün sonuçlarını yazmak mümkündür, fakat bazen yalnız kaç yazı geldiğiyle ilgileniriz. Farklı atış sıraları aynı sayıya karşılık gelebilir. Rastgele değişken, denemenin ayrıntılı sonucunu ilgilendiğimiz sayısal bilgiye dönüştürür. Bu sayıların olasılıkları bir dağılım oluşturur; ortalama ve yayılım da dağılımın farklı özelliklerini özetler.
Önceki yazıda örnek uzay, olay, koşullu olasılık ve bağımsızlığı kurduk. Şimdi bunları toplamlar ve integrallerle birleştireceğiz. Ayrık değerlerde tek tek olasılıkları, sürekli değerlerde ise aralık olasılıklarını kullanacağız. Son bölümde çok sayıda bağımsız ölçümün ortalamasının neden daha az oynadığını ve bunun hangi tür belirsizlikleri azaltmadığını açıklayacağız.
1. Rastgele değişken bir fonksiyondur
Bir örnek uzay üzerindeki rastgele değişken, her sonuca bir gerçek sayı atayan fonksiyonudur. Büyük fonksiyonun kendisini, küçük ise alabileceği belirli bir değeri gösterir. Rastgele olan, deneyin hangi sonucunun gerçekleşeceğidir; sayı atama kuralı sabittir.
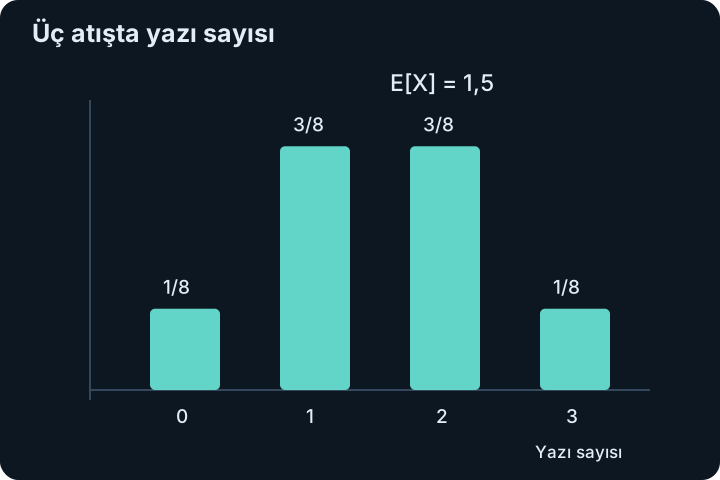
Üç para atışında yazı sayısı olsun. Yazı-tura-yazı ile tura-yazı-yazı farklı temel sonuçlardır, fakat ikisinde de olur. Adil ve bağımsız atışlarda sekiz sıralı sonuç eşit olasılıklıdır. değerlerinin olasılıkları sırasıyla ‘dir.
Bu dört sayısal sonuç eşit olasılıklı değildir. Rastgele değişken, birçok temel sonucu aynı değerde topladığı için ağırlıklar değişir. Önceki yazıdaki iki zarın toplamı örneği de aynı yapıya sahiptir. Dağılımı kurarken hangi temel sonuçların aynı sayıya gönderildiğini dikkatle sayarız.
2. Ayrık dağılım ve normalizasyon
Sonlu veya sayılabilir değerler alan bir değişkene ayrık rastgele değişken denir. fonksiyonu her değerin olasılığını verir; buna olasılık kütle fonksiyonu diyebiliriz. Koşullar:
şeklindedir. Toplamın 1 olması normalizasyon koşuludur: mümkün değerlerden biri gerçekleşecektir. Bir değer kümesine ait olasılık, o kümedeki kütlelerin toplamıdır.
Üç atış örneğinde olur. ‘dır çünkü bu değer sayım değişkeninin mümkün sonucu değildir. Birazdan ortalamasının 1,5 çıkması, deneyin tek seferde bir buçuk yazı üreteceği anlamına gelmeyecek.
Dağılım grafiğinde ayrık olasılıkları sütun yükseklikleri veya noktalarla gösterebiliriz. Sürekli yoğunluk grafiğindeki alan yorumunu bu sütunlarla karıştırmamalıyız. Ayrık modelde temel ağırlık tek tek değerlere atanır; eksen üzerinde çubukların görsel genişliğini değiştirmek olasılığı değiştirmez.
3. Birikimli dağılım iki türü birleştirir
Her rastgele değişken için birikimli dağılım fonksiyonu:
olarak tanımlanır. Girdi büyüdükçe daha çok sonucu kapsadığı için azalmayan bir fonksiyondur. Sol uçta 0’a, sağ uçta 1’e yaklaşır. Sağdan süreklidir; ayrık olasılık kütleleri grafikte sıçrama üretir.
Üç atış örneğinde için 0, için , için , için , için 1 olur. Her sıçramanın büyüklüğü ilgili noktanın olasılığıdır. Örneğin 2 noktasındaki sıçrama ‘dir.
Aralık olasılığı ile bulunur. Uçlardaki eşitlik işaretleri ayrık modellerde önemlidir. Sürekli yoğunluğu olan modellerde tek noktanın olasılığı sıfır olacağı için açık veya kapalı uç aynı sonucu verir. Bu farkı dağılım türünden bağımsız bir yazım alışkanlığı gibi görmeyiz.
4. Beklenen değer ağırlıklı ortalamadır
Ayrık için beklenen değer veya ortalama:
olarak tanımlanır; sonsuz değer kümesinde koşulu ortalamanın sonlu ve iyi tanımlı olması için yeterlidir. işleci olasılık ağırlıklı toplama yapar. harfi ortalamayı gösterir.
Üç adil atışta olur. Bu sayı olası tek bir sonuç olmak zorunda değildir; çok sayıda tekrardaki ortalamanın etrafında toplandığı merkezdir. “Beklenen” sözcüğü “bir sonraki denemede kesin çıkacak” anlamına gelmez.
Bir fonksiyonu için kullanılır. Özellikle kareleri önce alıp sonra ağırlıklı toplar. Genel olarak ile aynı değildir. Ortalama alma doğrusal işlemlere dağılır, fakat kare alma gibi doğrusal olmayan işlemlere gelişigüzel taşınamaz.
5. Varyans ve standart sapma
Ortalama çevresindeki yayılımı ölçmek için sapmaların karelerinin ortalamasını alırız:
İkinci eşitlik kareyi açıp kullanmaktan gelir. Varyans negatif olamaz. Standart sapma ‘dır. metre birimindeyse varyans metrekare, standart sapma metre birimindedir. Standart sapmayı kullanmanın yararlarından biri, asıl değişkenle aynı birimde olmasıdır.
Üç atışta olur. Varyans , standart sapma ‘dir. Bu değer dağılımın ne kadar yayıldığını özetler. Ortalama tek başına yeterli değildir: sürekli 1 üreten değişkenle eşit olasılıkla 0 veya 2 üreten değişkenin ortalaması 1’dir, fakat varyansları sırasıyla 0 ve 1’dir.
Standart sapma genel olarak ortalamadan mutlak uzaklığın ortalaması değildir. Kare alma uzak sapmaları daha güçlü ağırlıklandırır. Hangi yayılım ölçüsünün kullanıldığını söylemek, farklı raporlardaki sayıları doğru karşılaştırmak için gerekir.
6. Bernoulli ve binom dağılımı
Tek denemede başarıya 1, başarısızlığa 0 veren değişken Bernoulli değişkenidir. Başarı olasılığı ise , olur. olduğundan ve bulunur.
Bağımsız, aynı başarı olasılığına sahip Bernoulli denemesinin başarı sayısına binom dağılımlı değişken denir. Tam başarı için başarı konumları biçimde seçilir. Her sıranın olasılığı olduğundan:
Toplamın 1 olması binom açılımından da görülür: . Denemelerin olasılıkları farklıysa veya denemeler bağımlıysa bu formül doğrudan kullanılamaz.
Her denemenin gösterge değişkenini yazarsak toplam başarı sayısı ‘dir. Beklenen değerin doğrusallığı verir. Bağımsızlık altında varyanslar da toplanır ve olur. Varyans toplamının neden bağımsızlık istediğini birazdan kovaryansla açıklayacağız.
7. Sürekli yoğunluk nokta olasılığı değildir
Yoğunluk fonksiyonu olan bir sürekli rastgele değişkende ve:
olur. Olasılık eğrinin yüksekliği değil, aralık altındaki alandır. değeri 1’den büyük olabilir; toplam alan 1 kaldığı sürece sorun yoktur. saniyeyle ölçülüyorsa yoğunluğun birimi saniyenin tersidir, böylece yoğunluk ile aralık genişliğinin çarpımı boyutsuz olasılık verir.
Tek noktada aralık genişliği sıfır olduğundan olur. Buna rağmen bir denemede bir değer gerçekleşir. Sürekli modelde sıfır olasılık, mantıksal olarak boş olayla aynı değildir. Gerçek ölçüm cihazları da genellikle tam bir gerçek sayı yerine sonlu çözünürlüklü bir aralık raporlar.
Yoğunluk varsa olur. Yoğunluğun sürekli olduğu noktalarda temel teorem verir. Her dağılımın yoğunluğu olmak zorunda değildir; ayrık ve sürekli bileşenleri karışan modeller de vardır. Burada iki temel türü ayrı ve açık biçimde kuruyoruz.
8. Düzgün dağılım örneği
aralığında eşit uzunluktaki aralıkların eşit olasılıklı olduğu modelde yoğunluk , dışarıda 0’dır. Buna düzgün dağılım denir. Yükseklik ile toplam genişliğin çarpımı 1 olduğundan normalizasyon sağlanır.
, 2 ile 6 arasında düzgün dağılsın. Yoğunluk , olur. Ortalama:
İkinci moment ve varyans olur. Standart sapma ‘tür. Genel hesap düzgün dağılımda ortalamanın , varyansın olduğunu verir.
Sürekli beklenen değerlerin formülü de aynı ağırlıklı toplama fikridir: , uygun integrallenebilirlik koşuluyla. Ayrık toplam ile sürekli integral arasında kavramsal farktan çok ağırlığın nasıl dağıtıldığı farkı vardır.
9. Gauss dağılımı ve normalizasyon
Ortalaması , standart sapması olan normal veya Gauss yoğunluğu:
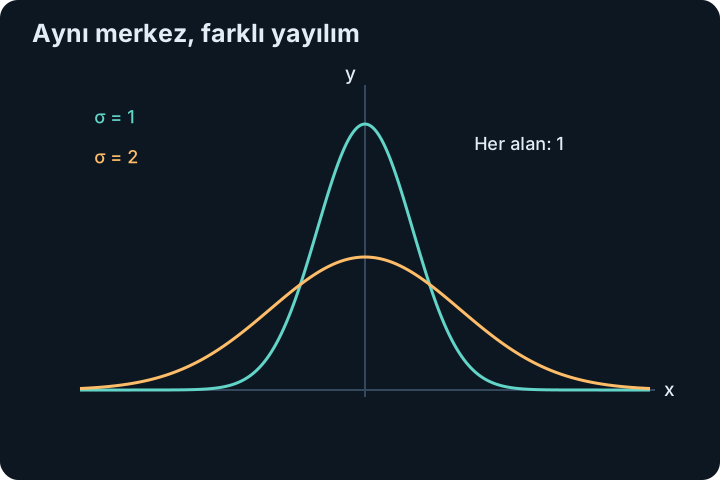
şeklindedir. gösterimidir. Önceki integral yazısında sonucunu bütün gerçek doğru için kurduk. konunca integral olur; öndeki katsayı bunu 1’e normalleştirir.
eğrinin merkezini kaydırır. büyürse dağılım yayılır ve tepe alçalır; alan 1 kalır. Yoğunluğu genişletirken yüksekliği aynı bırakmak toplam olasılığı değiştirirdi. Standart normal değişken için , ‘dir. Genel değişkenini ile standart ölçeğe dönüştürebiliriz.
Simetriden standart normalin ortalaması 0’dır. Varyansını görmek için yazalım. olduğundan kısmi integrasyon:
verir. Üstel kuyruk yüzünden sınır terimi sıfırdır. Dolayısıyla ölçekleme sonrası ‘in varyansı gerçekten olur; parametrenin adı formülle uyumludur.
10. Ölçek ve değişken dönüşümü
olsun. Beklenen değerin doğrusallığı verir. Merkezden sapma olduğundan:
Kaydırma ortalamayı değiştirir ama yayılımı değiştirmez. Negatif yönü ters çevirir; standart sapma negatif olamayacağı için mutlak değer kullanılır. Birim dönüşümlerinde bu fark özellikle önemlidir.
Yoğunluğu dönüştürmek için durumunda ve küçük uzunlukların ilişkisi kullanılır. Sonuç olur. Bu, çok katlı integrallerde gördüğümüz Jacobian ölçek fikrinin tek değişkenli biçimidir. Daha genel dönüşüm birden çok girdiyi aynı çıktıya götürüyorsa bütün uygun ters dalların katkıları toplanmalıdır.
Örneğin , üzerinde düzgünse , üzerinde yoğunluğu olan düzgün dağılımdır. Aralık iki kat genişlediği için yükseklik yarıya iner. ise sabit değişkendir; sıradan sürekli yoğunluk formülünde sıfıra bölme yapamayız.
11. Kovaryans ve toplamın yayılımı
İki değişkenin birlikte sapmasını kovaryans ölçer:
Sonlu ikinci momentler altında biçiminde de yazılır. Pozitif değer, merkezden sapmaların aynı yönde birlikte olma eğilimini; negatif değer zıt yönü gösterir. Birimi ile birimlerinin çarpımıdır.
Kare açılımından:
elde edilir. Bağımsız değişkenlerde ortak dağılım ayrıştığı için ve kovaryans sıfır olur. Böylece varyanslar toplanır. Beklenen değerlerin toplanması ise bağımsızlık gerektirmez; bu iki kuralı ayırmalıyız.
Sıfır kovaryans bağımsızlık demek değildir. , üzerinde düzgün olsun ve seçilsin. Simetriden , olduğundan kovaryans sıfırdır. Buna rağmen , tarafından tamamen belirlenir. Kovaryans yalnız belirli bir doğrusal birlikte değişim bilgisidir; bütün bağımlılık türlerini yakalamaz.
12. Çok sayıda tekrarın ortalaması
bağımsız, aynı dağılımlı, sonlu ortalama ve sonlu varyans taşısın. Örnek ortalaması olsun. Doğrusallık ve bağımsızlıkla:
Dolayısıyla ortalamanın standart sapması ‘dir. Dört kat tekrar, bu ideal koşullarda ortalamanın yayılımını ikiye indirir. Tek tek ölçümlerin dağılımı daralmaz; onların ortalamasının dağılımı daralır.
Bu sonuç büyük sayılar yasasının bir biçimini de açıklar. Her için Chebyshev eşitsizliği:
verir. Eşitsizliğin fikri basittir: sapma en az olan olayda sapmanın karesi en az ‘dir. Kare sapmanın ortalaması bu olayın olasılığının katından küçük olamaz. Düzenleyince sınır bulunur.
Bu, her yeni denemede ortalamanın merkeze monoton yaklaşacağını söylemez. Belirli bir sonlu tekrar sayısında tam eşitlik de garanti etmez. Söylediği şey, sabit bir hata eşiğini aşma olasılığının çok sayıda bağımsız tekrarda küçülmesidir. Varsayımlar bozulursa aynı sonuç otomatik uygulanmaz.
13. Ölçüm yayılımı ile başka belirsizlikleri ayırmak
Bir ölçüm modeli olsun. sabit gerçek değer, bağımsız, sıfır ortalamalı hata olsun. Bu modelde tekrar ortalamasının rastgele yayılımı azalır. Fakat cihaz her ölçüme aynı yanlılığını ekliyorsa ortalama çevresine yaklaşır; tekrar sayısını artırmak bu kaymayı gidermez.
Bağımsızlık da sınanması gereken bir varsayımdır. Ortak sıcaklık değişimi veya aynı kalibrasyon hatası bütün ölçümleri birlikte etkileyebilir. Böyle durumlarda kovaryans terimleri toplamın varyansına katkı yapar ve basit hesabı yetersiz kalabilir. İstatistiksel modelin hangi belirsizliği temsil ettiği açıklanmalıdır.
Buradaki standart sapma dağılımın yayılımıdır. Onu cihaz çözünürlüğü, tahminin hata payı veya ileride karşılaşacağımız kuantum belirsizlik ilişkileriyle isim benzerliği üzerinden özdeşleştirmeyeceğiz. Aynı matematiksel ölçü farklı bağlamlarda kullanılabilir, fakat nedenleri ve yorumları ayrıca kurulur.
Olasılığın sayısal dili artık hazır: dağılım bütün ağırlıkları, beklenen değer merkezi, varyans ve standart sapma yayılımı, kovaryans ise iki değişkenin birlikte değişimini anlatır. Bundan sonra fiziksel büyüklükleri ölçmeye, birimlerle ifade etmeye ve bir modelin hangi koşullarda geçerli olduğunu sorgulamaya başlayacağız.